Modernes RAG, Teil 1: Das Schwierige ist nicht die Generierung – es ist das Retrieval
7/7/2026
Richard Vlas
Large Language Models sind beeindruckend. Sie können flüssige Antworten generieren, Dokumente zusammenfassen, komplexe Themen erklären und dabei überzeugend klingen.
Aber es gibt eine wichtige Einschränkung.
Für sich allein haben sie keinen Zugriff auf Ihre privaten Dokumente, internen Wissensdatenbanken, Produktkataloge, Maschinenbücher, Service-Tickets, Projektspezifikationen oder Confluence-Seiten.
Aus diesem Grund verwenden viele reale KI-Systeme Retrieval-Augmented Generation, üblicherweise als RAG bezeichnet.
Die grundlegende Idee ist einfach:
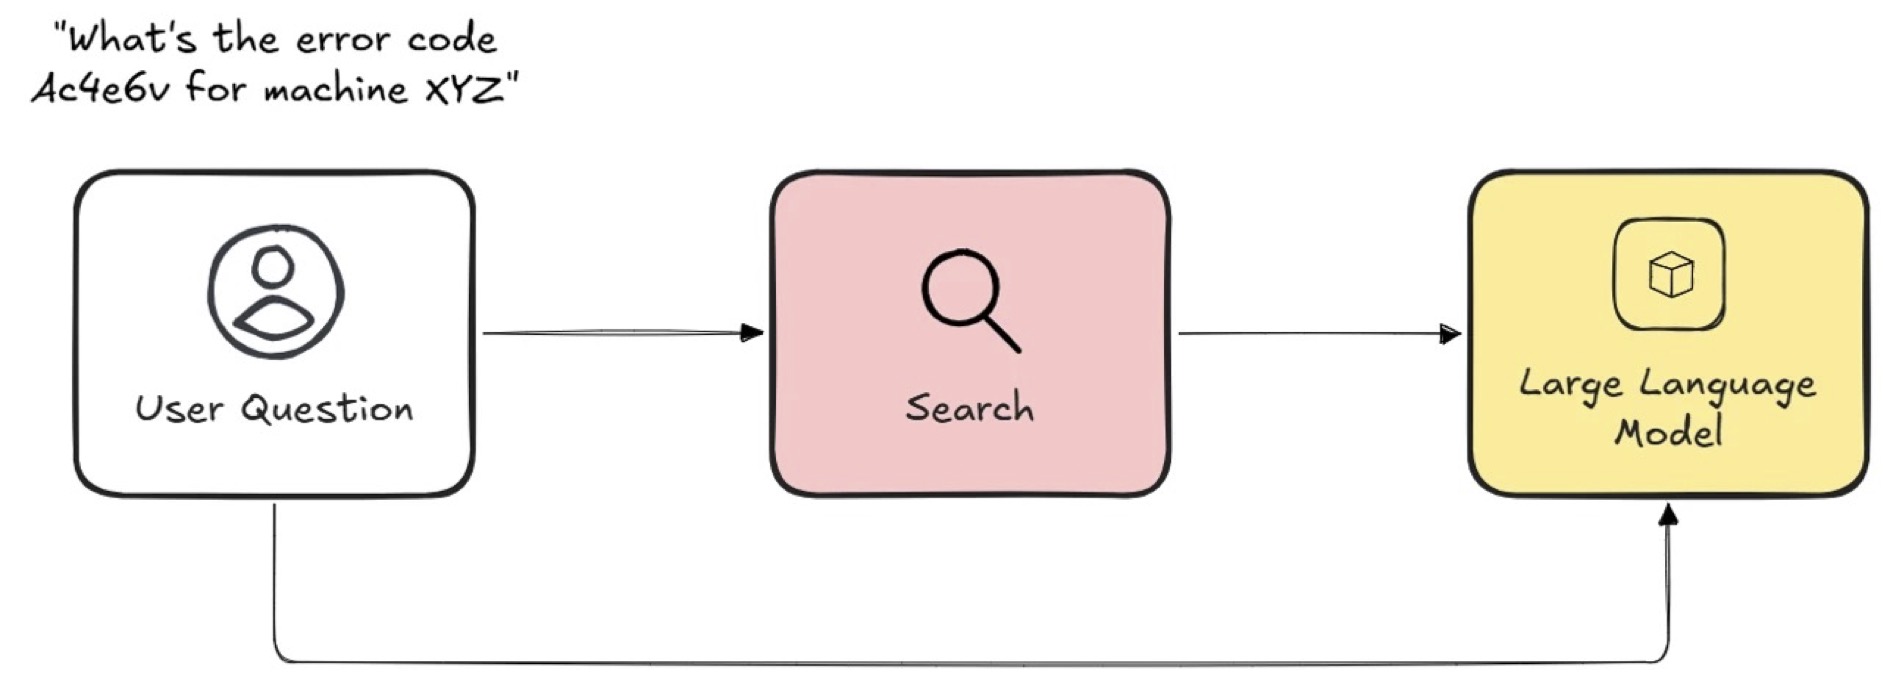
Bevor das LLM antwortet, sucht das System zunächst nach relevanten Informationen. Diese Informationen werden dem Modell dann als Kontext übergeben. Das Modell antwortet auf Basis dieses abgerufenen Kontexts.
Das klingt einfach, aber in der Praxis liegt die Schwierigkeit meist nicht bei der Generierung. Die Herausforderung liegt beim Retrieval.
Die richtigen Informationen zu finden ist deutlich schwieriger, als es aussieht.
Ein einfaches RAG-System funktioniert möglicherweise gut für eine kurze Suchanfrage wie:
servo alarm F217
Aber echte Nutzer stellen selten perfekte Suchanfragen. Sie fragen Dinge wie:
The machine stops with servo alarm F217 after the gripper module was replaced.
What is causing it, and which machine variants are affected?
Das ist keine einfache Suche. Sie enthält mehrere Informationsbedürfnisse.
Das System muss verstehen, was Alarm F217 bedeutet. Es muss den Alarm mit dem Austausch des Greifer-Moduls in Verbindung bringen. Es muss nach möglichen Grundursachen suchen. Möglicherweise muss es auch herausfinden, welche Maschinenvarianten dieselbe Servo- oder Greiferkonfiguration verwenden. Und schließlich muss es eine fundierte Antwort mit Belegen liefern.
Eine einfache Vektorsuche liefert möglicherweise nur die am ähnlichsten aussehenden Textabschnitte. Sie findet beispielsweise ein Dokument über Alarm F217, verfehlt aber die Informationen zur Maschinenvariante. Oder sie findet ein Service-Ticket, aber nicht das offizielle Wartungshandbuch.
Deshalb bin ich der Meinung, dass RAG nicht auf „Vektordatenbank plus LLM" reduziert werden sollte.
Das ist zu vereinfacht.
Ein zuverlässiges RAG-System benötigt einen Retrieval-Stack.
Es muss verschiedene Arten von Quellen durchsuchen: Handbücher, Tickets, Service-Berichte, PDFs, Meeting-Notizen, Confluence-Seiten, Produktkataloge und strukturierte Datenbanken.
Und das muss so geschehen, dass dem LLM die richtigen Belege geliefert werden – nicht nur irgendwelche ähnlich aussehenden Textabschnitte.
Das Ziel ist nicht, eine flüssige Antwort zu produzieren.
Das Ziel ist, eine fundierte Antwort zu produzieren.
Das bedeutet: Das Modell soll keine fehlenden Fakten erfinden. Es soll antworten, indem es die abgerufenen Informationen als Belege verwendet.
Das ist die eigentliche Herausforderung bei Enterprise-RAG.
Das LLM ist nur der letzte Schritt. Die Qualität der Antwort hängt stark davon ab, was das System abruft, bevor das LLM zu schreiben beginnt.
In dieser Serie möchte ich Schritt für Schritt die Retrieval-Techniken durchgehen, die moderne RAG-Systeme zuverlässiger machen.
In diesem ersten Teil haben wir mit der Grundidee begonnen: RAG dreht sich nicht hauptsächlich um die Textgenerierung. Es geht darum, die richtigen Informationen zu finden, bevor das Modell antwortet.
Im nächsten Beitrag beginne ich mit der ältesten Retrieval-Technik, der Keyword-Suche, und erkläre, warum BM25 in modernen RAG-Systemen nach wie vor sehr relevant ist.
Richard ist ein Mitglied des SABO-Kernteams, in dem er tiefgehende technische Expertise mit einem Fokus auf klares Design und bewährte Methoden verbindet. Als Senior Machine Learning Engineer und Softwarearchitekt arbeitet er an intelligenten Systemen wie Konversationsassistenten und KI-gesteuerten industriellen Lösungen. Seine Arbeit schlägt eine Brücke zwischen moderner Softwarearchitektur und praxisnahen Anwendungen des maschinellen Lernens, häufig unter Einbeziehung von MLOps und skalierbarer Infrastruktur. In seiner Freizeit lernt er gerne neue Sprachen und erkundet, wie diese unsere Denk- und Kommunikationsweise beeinflussen.
SABO IT entwickelt Individualsoftware für Unternehmen mit komplexen technischen Prozessen, vom Steuergerät über die Cloud bis in die Unternehmenssysteme, auch in regulierten Umgebungen. Dazu kommen eigene Plattformen: SenseDrive für geprüfte Antworten aus dem eigenen Wissensbestand und SABOT für die Sprachbedienung von Maschinen. Softwareentwicklung seit 1983, als SABO IT seit 2012; die durchschnittliche Kundenbeziehung dauert 6,5 Jahre.
Was kostet KI im Unternehmen wirklich? Warum der Preis pro Nutzer die falsche Zahl ist
Drei Meldungen aus diesem Jahr zeigen, warum Rechenleistung für europäische Unternehmen zu einer strategischen Frage wird: Laut Siemens-Vorstand Cedrik Neike liegen europäische Rechenzentren bei den Betriebskosten 20 bis 30 Prozent über dem US-Niveau, zahlen würden Unternehmen dafür nach seiner Einschätzung aber nur 5 bis 10 Prozent mehr.